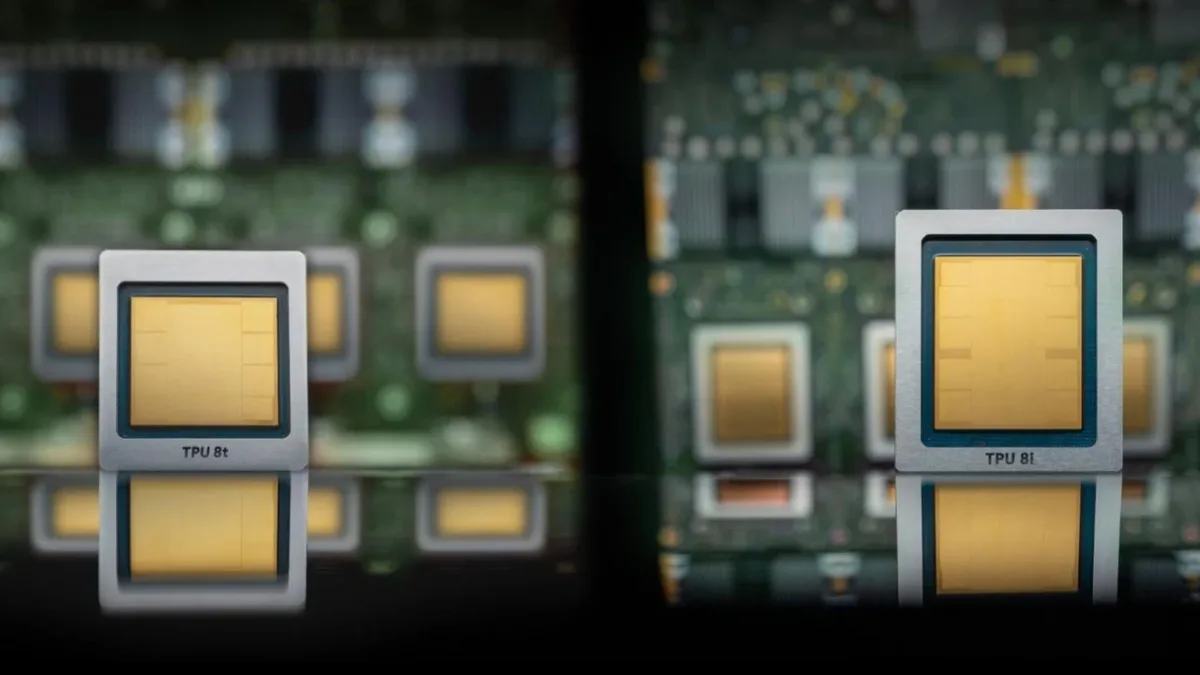
Google, yapay zeka modellerinin uzun metinler ve videolarla çalışırken karşılaştığı bellek darboğazına iki çipi tek pakette birleştirerek yanıt veriyor. Şirketin 9 Kasım’da duyurduğu TPU 8i Max, mevcut TPU 8i çiplerinden ikisini birlikte kullanıyor. Aynı duyurudaki TPU 8tx ise verilerini işlem sırasında da korumak isteyen kurumlara yönelik.
Bunlar yeni bir TPU çip nesli değil. Google, sekizinci nesil TPU ailesinin mevcut işlemcilerini farklı ağ, işlemci ve paketleme düzenleriyle iki ayrı sistem haline getiriyor. Dolayısıyla duyuru, oyuncuların bilgisayarına takacağı bir ekran kartından çok, yapay zeka hizmetlerinin çalıştığı veri merkezi altyapısını ilgilendiriyor.
İki TPU 8i, tek paket
TPU 8i Max’in hedefi, modelin bir isteği yanıtlarken çok büyük miktarda bilgiyi birlikte değerlendirmesi gereken işler. Google, bütün bir kod tabanının veya saatlerce videonun bağlam olarak kullanılmasını örnek veriyor. Bu ölçekte yalnız hesaplama gücü değil, verinin bellekte tutulması ve işlemciye ne hızla ulaştırıldığı da belirleyici oluyor.
Şirkete göre iki TPU 8i çipinin tek pakette birleştirilmesi, standart TPU 8i’ye kıyasla hesaplama gücünü, çip üzerindeki SRAM miktarını ve yüksek bant genişlikli bellekten (HBM) veri aktarım hızını iki katına çıkarıyor. Buradaki HBM iddiası bellek kapasitesinin değil, bant genişliğinin iki katına çıkması. Google ayrıca aynı sunucu rafı alanına iki kat çip yerleştirilebildiğini belirtiyor.
TPU 8tx, hassas verilerle çalışan kurumlara yöneliyor
TPU 8tx, eğitim odaklı TPU 8t ile aynı çipi kullanıyor; buna beşinci nesil AMD EPYC sunucu işlemcileri ve çıkarım işlerine yönelik düşük gecikmeli Boardfly ağı eşlik ediyor. Çıkarım, eğitilmiş bir modelin gelen isteği işleyip yanıt üretmesi anlamına geliyor.
Bu sistemde öncelik, verileri ve model ağırlıklarını yalnız depolanırken veya aktarılırken değil, aktif olarak işlenirken de korumak. Google, özellikle sıkı veri koruma yükümlülükleri bulunan kurumları ve kamu kuruluşlarını hedefliyor. Şirketin açıklamasına göre TPU 8tx, TPU 8t’ye kıyasla gecikmeyi yarıya kadar azaltabiliyor; gizli hesaplama korumasının performansa etkisi de sıfıra yakın. Bunlar Google’ın performans iddiaları; bağımsız test sonucu değil.
8tx yalnız yanıt üretmek için tasarlanmamış. Küçük ölçekli eğitim, özel verilerle ince ayar, büyük bir modelin yeteneklerini daha küçük modele aktarma ve pekiştirmeli öğrenme de aynı sistemde yapılabiliyor. Böylece bu işleri farklı kümeler arasında taşımadan yürütmek amaçlanıyor.
Duyuru, Google’ın TPU yatırımlarının ticari karşılığının büyüdüğü bir döneme denk geliyor. Şirketin son bilançosunda Google Cloud’un büyümesine TPU sistemi satışlarının da katkı verdiği açıklanmıştı. Google, yeni iki sistem için bu duyuruda fiyat veya kesin bir genel kullanıma açılma tarihi paylaşmadı.


Yorumlar
İlk yorumu siz yazın!
Yanıt: —