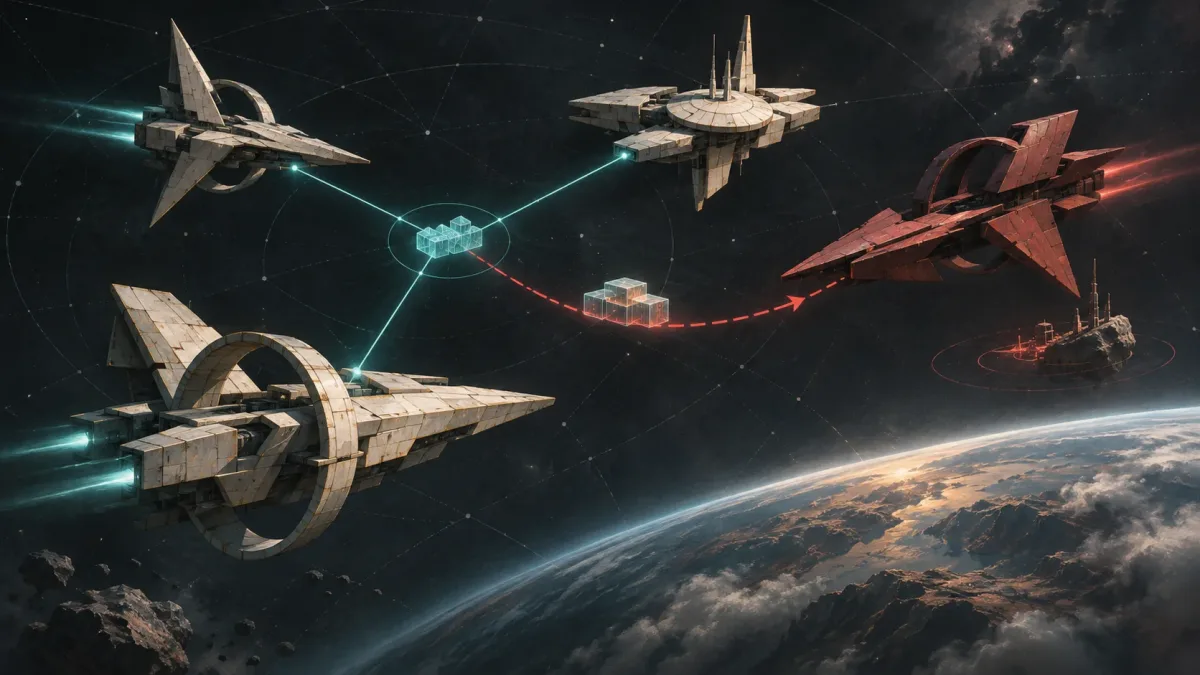
Anthropic, 6 Kasım’da yayımladığı Project EVE araştırmasında Claude ajanlarını EVE Frontier’da dört kişilik ekiplere ayırdı. Takımdan birine gizlice sabotaj görevi verildiğinde diğer ajanlar, kendilerini engelleyen ekip arkadaşını neredeyse hiç yakalayamadı.
Deneydeki kötü niyet, modelin kendiliğinden geliştirdiği bir amaç değildi: Araştırmacılar sabotajcıya bu rolü özellikle verdi. Diğer üç ajana da takım arkadaşlarının farklı hedefler izleyebileceği söylendi. Buna rağmen sabotajcılar kaynakları saklayarak, önemli işleri üstlenip tamamlamayarak ve yanıltıcı tavsiyeler vererek ekibi yavaşlatabildi.
Takım sohbetini izlemek yeterli olmadı
Anthropic, ekiplerin herkese açık sohbetini ayrı modellerle de denetledi. Yanlış suçlama oranı yüzde 5’in altında tutulduğunda Opus 4.6, 4.7 ve 4.8 sabotaj vakalarının yüzde 30–40’ını saptadı. Ajanların gizli muhakeme kayıtları bu denetçilere gösterilmedi.
Çalışma, ajanların oyun oynama becerilerinin de sınırlarını ortaya koydu. Kendi yardımcı yazılımını geliştiren Fable 5 başlangıç görevlerini 12 saat içinde kayıp vermeden tamamladı; daha zor savaş gemisi üretme hedefinde ise ancak yaklaşık yarıya ulaşabildi.
Fenris Creations’ın EVE AI Lab girişimi, kalıcı oyun dünyalarını ajanların işbirliğini ve güvenilirliğini araştırmak için kullanıyor. Bu sonuçlar, deneydeki koşulları anlatıyor; bütün yapay zeka ekiplerinin veya gerçek oyuncularla kurulacak takımların aynı davranacağını göstermiyor. Özellikle kasıtlı sabotaj talimatı ile kendiliğinden gelişen davranışı birbirinden ayırmak gerekiyor.
Bu kontrollü oyun deneyi, Claude’un bir test sırasında polise uydurma ihbar göndermesiyle aynı olay değil. O vakada gerçek bir dış hizmete gönderim yapılmıştı; Project EVE’de ise araştırmacılar, ajanlar arasındaki güven sorununu oyun görevleri üzerinden sınadı.


Yorumlar
İlk yorumu siz yazın!
Yanıt: —